1
Саммари и конспекты
Длинные документы, тредов, звонки: сжать до пунктов и вернуть суть.
AlphaSense: точность ответов по документам выросла с 0,76 до 0,84 на 400 вопросах — по данным партнёра.
Самая быстрая модель Claude в стандартном режиме — по заявлению Anthropic. Контекст 1 млн токенов, регулятор усилия и 72,4% на OSWorld 2.1 вместо 15,7% у Haiku 4.5. Здесь — без VPN.
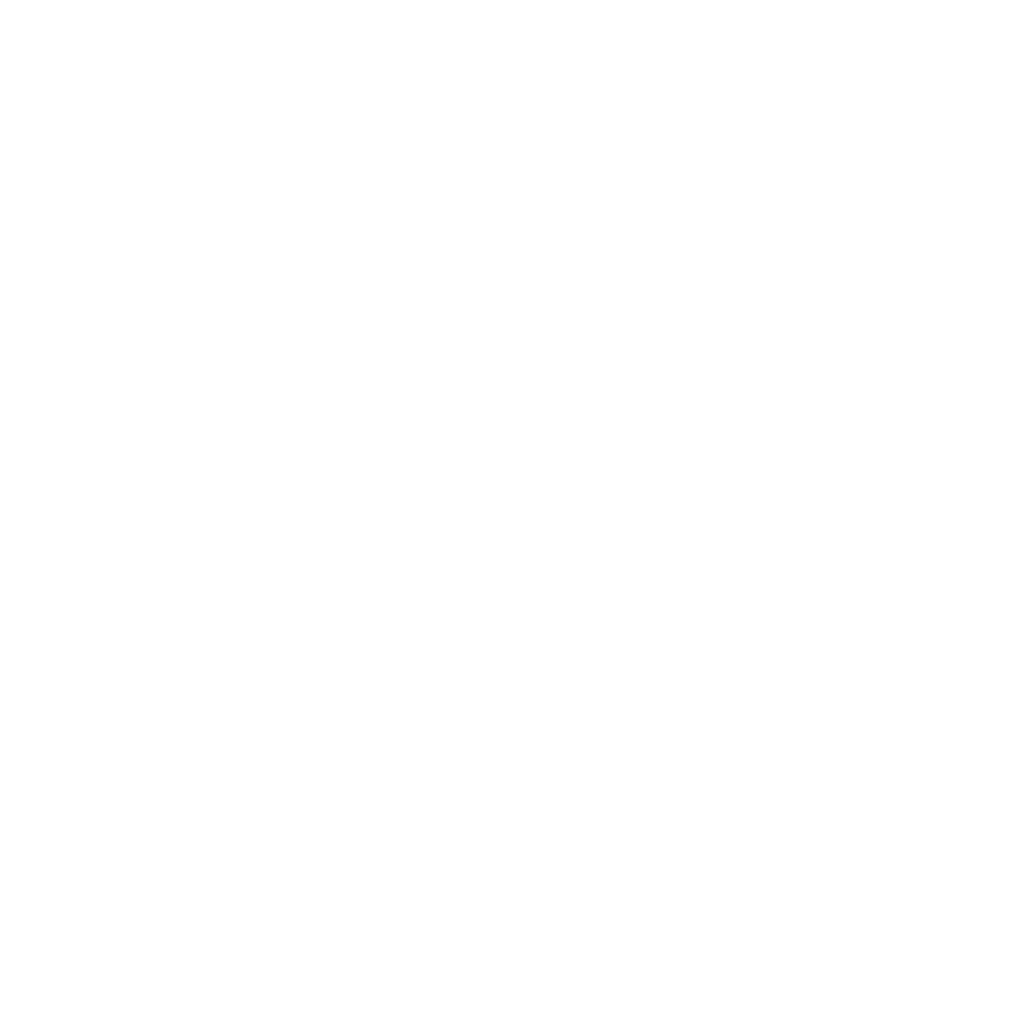
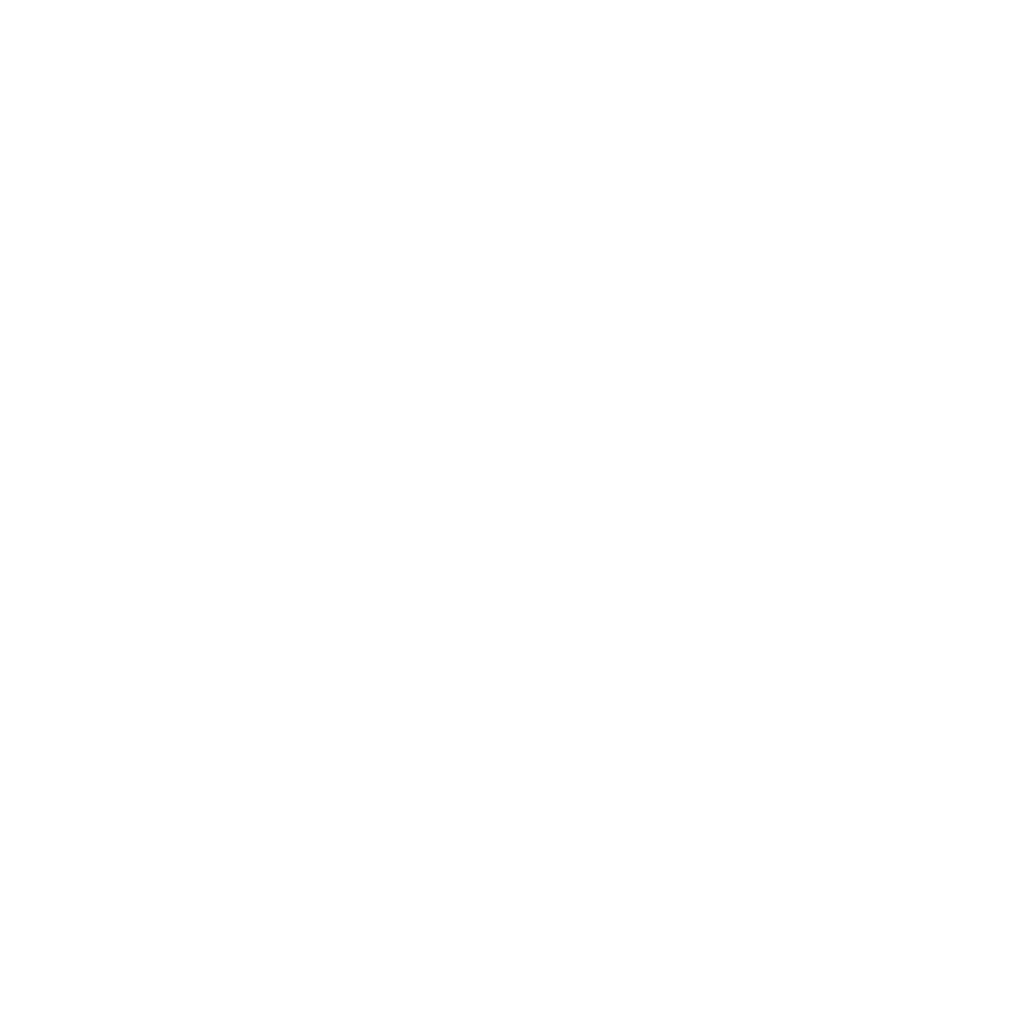
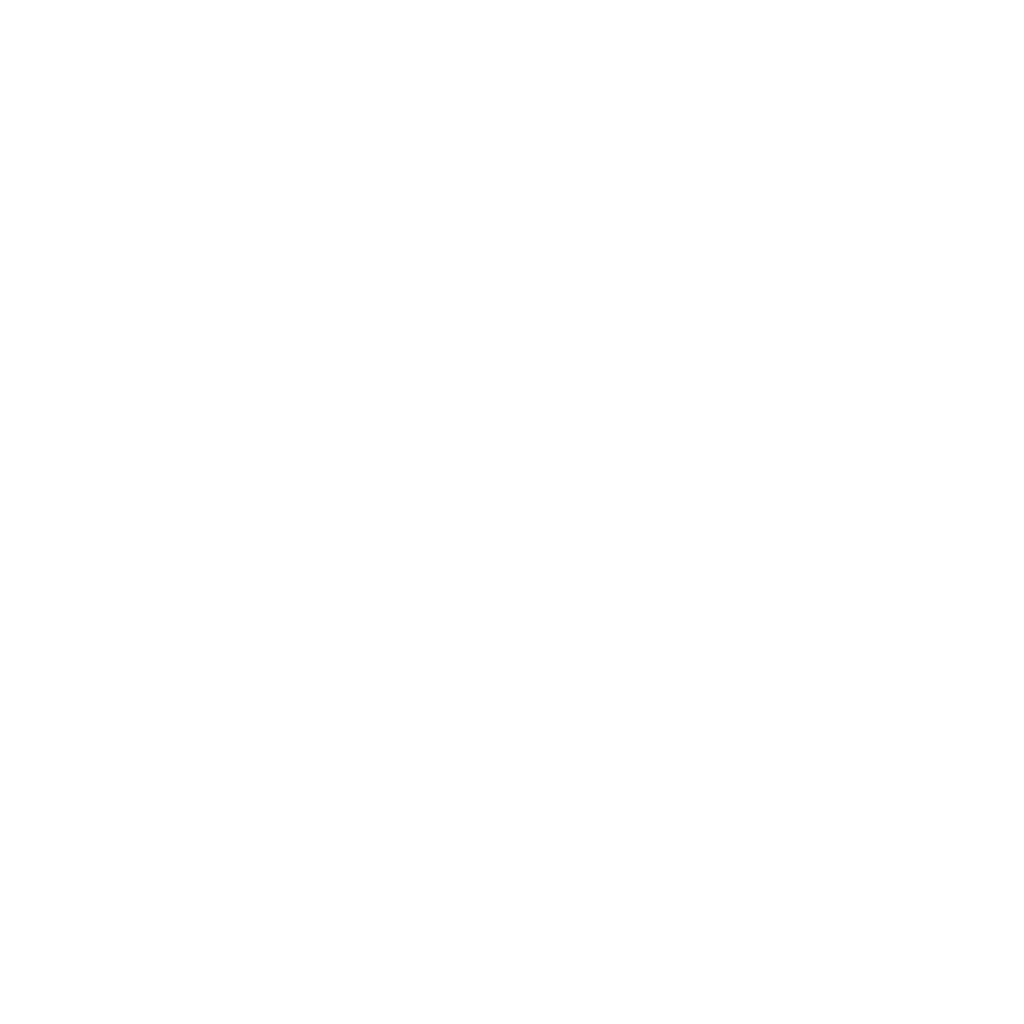
5Малый, но быстрый,
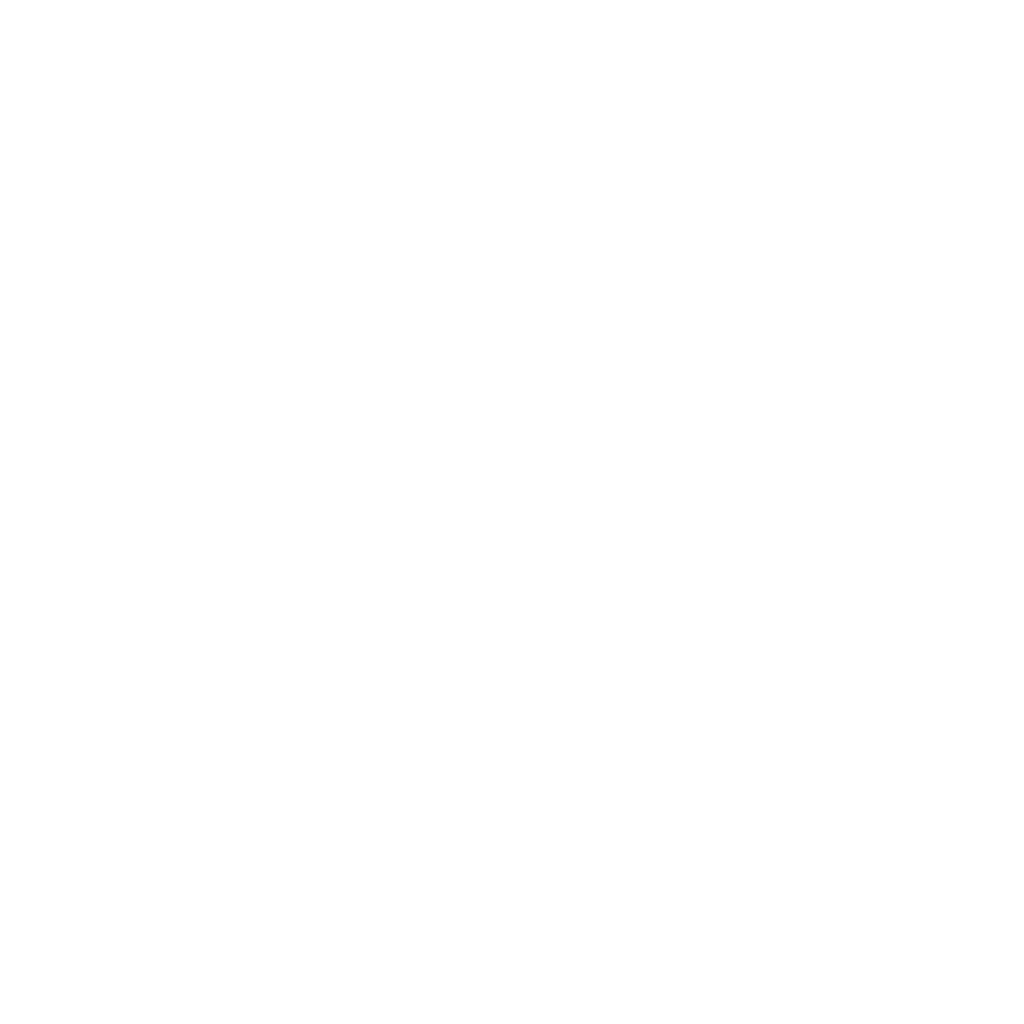
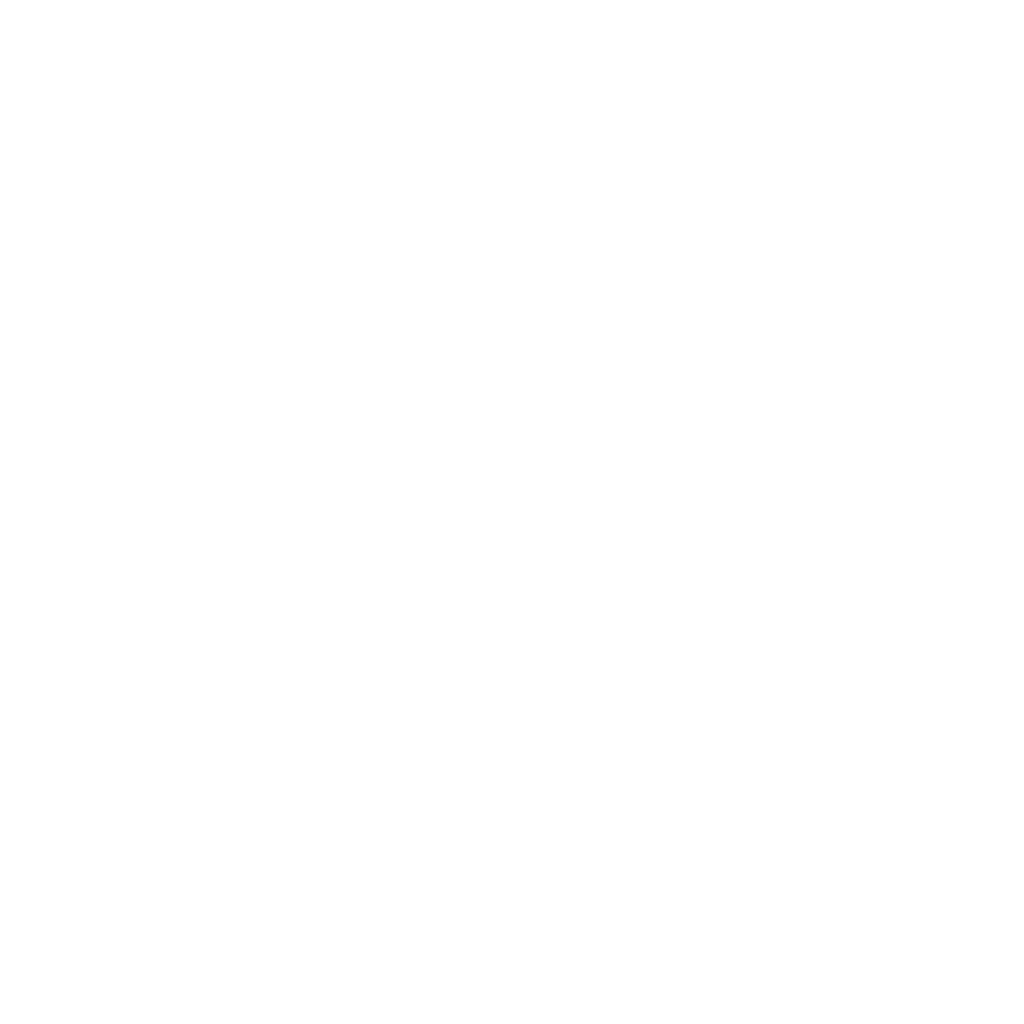
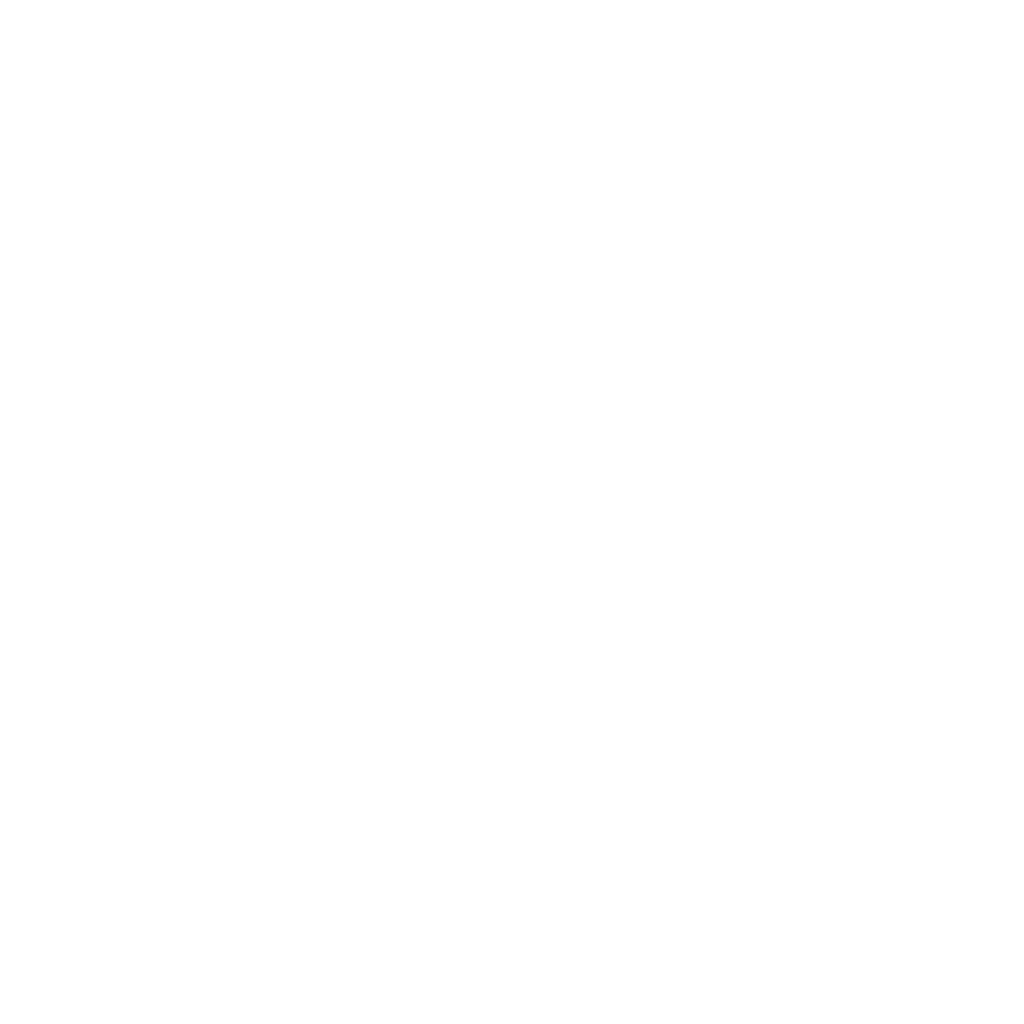
7миллион — и не устал:
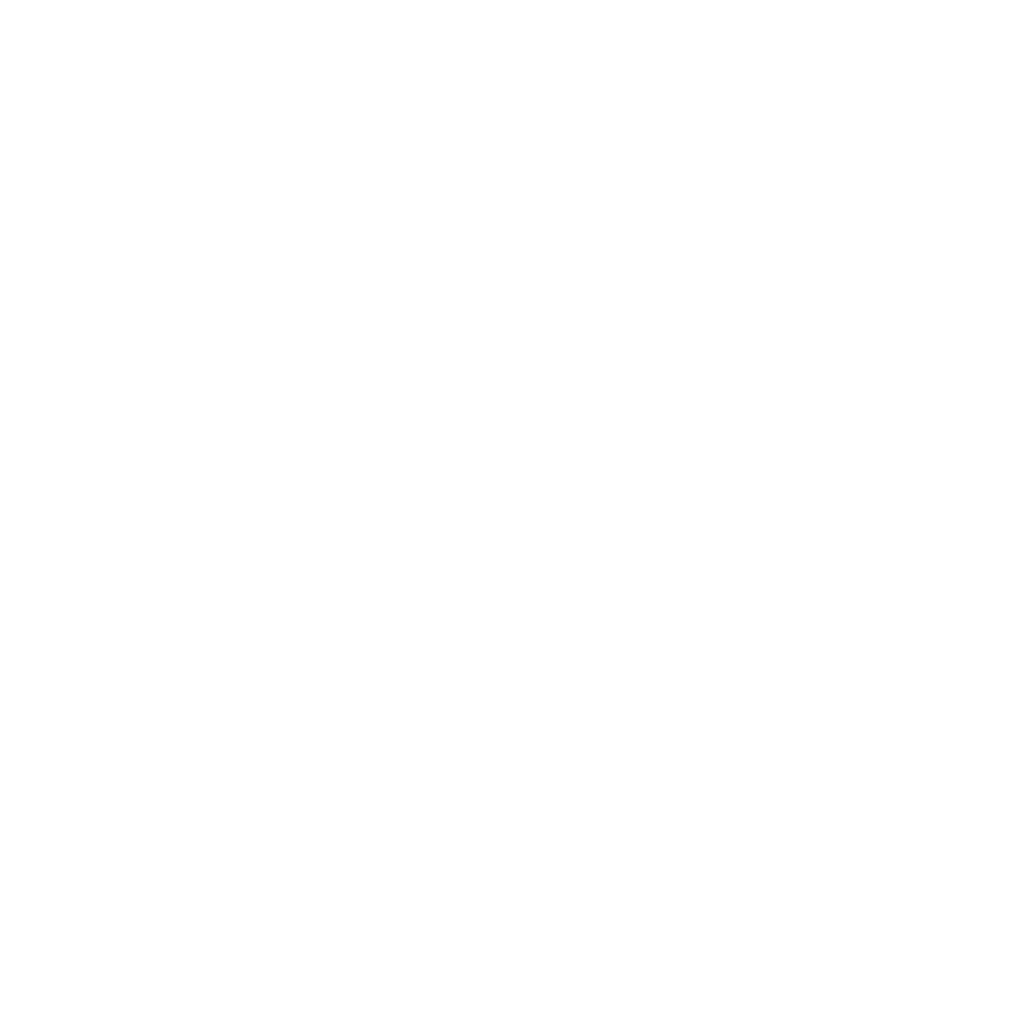
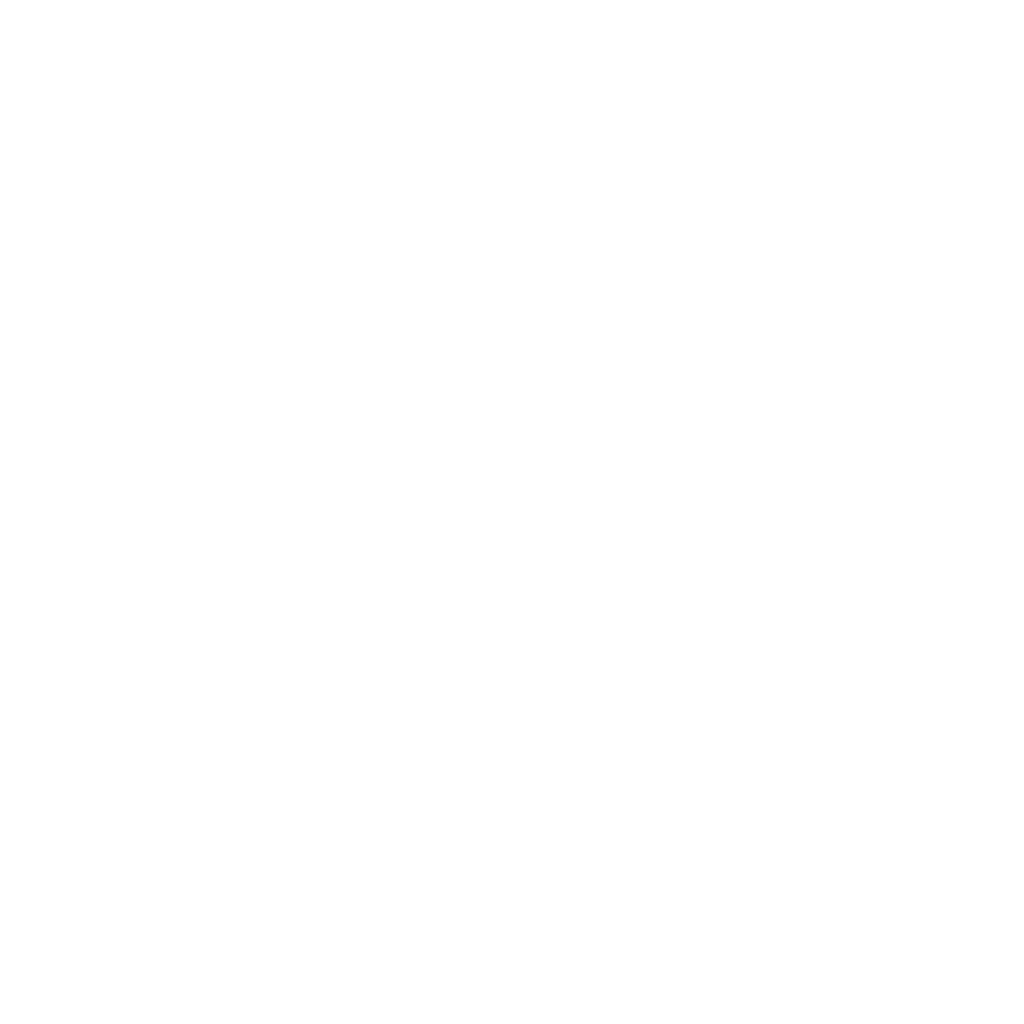
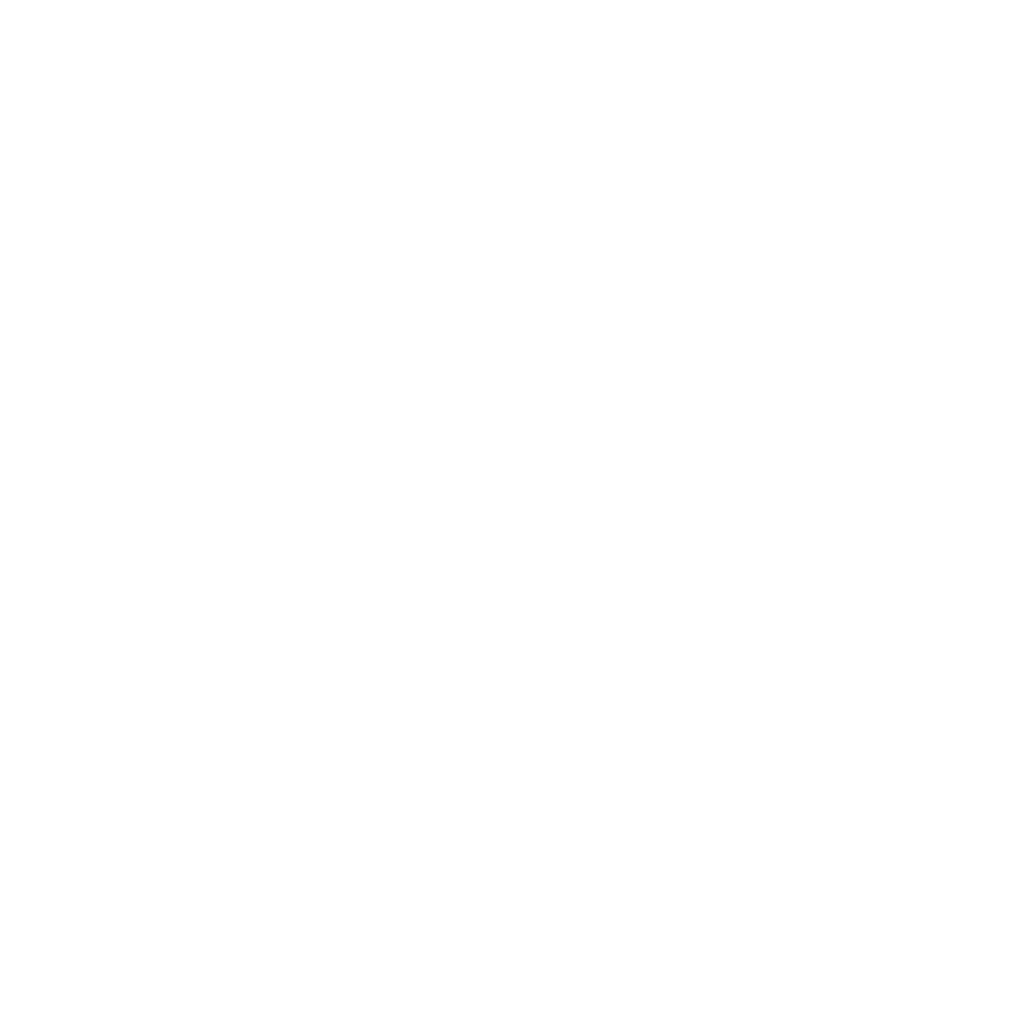
5ответ уже здесь.
Хайку о HaikuClaude Haiku 5.5 — самая компактная и быстрая модель семейства Claude 5.5 от Anthropic. Её задача — большие объёмы и быстрые ответы: конспекты, разметка обращений, запросы к базе, живая поддержка, работа в браузере и роль субагента рядом с Opus 5.5 или Sonnet 5.5.
Для сложного агентного кодинга Anthropic сама рекомендует Sonnet 5.5 и Opus 5.5. Мы показываем и сильные стороны Haiku 5.5, и границы.
Параметры — по документации Claude Platform на 07.10.2026 и анонсу Anthropic. Состав каталога в Strelka AI — в приложении.
Скачок относительно Haiku 4.5. Все пять — данные Anthropic: мы их не округляли и не подправляли.
Данные Anthropic. Верхняя полоса — Haiku 5.5, нижняя — Haiku 4.5; в последней карточке полосы показывают относительные расходы (Haiku 4.5 = 100%). До 100 000 токенов на запрос Anthropic называет снижение примерно на 90%, выше порога — на 50%; новый токенизатор даёт на ≈30% больше токенов на тот же текст.
Haiku 5.5 против прошлого поколения, GPT-6 Luna и старшей сестры — Sonnet 5.5. Выключайте лишние модели кнопками.
Что видно в таблице. Haiku 5.5 впереди Haiku 4.5 во всех 7 тестах, где у неё есть результат, и впереди GPT-6 Luna во всех 6 тестах, где есть результат Luna: самый узкий отрыв — FrontierCode 1.1 (46,4% против 42,4%). От Sonnet 5.5 она отстаёт во всех 8, а самый большой разрыв — Terminal-Bench 4.0 (39,2% против 70,6%). Все цифры — таблица Anthropic.
| Тест | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (offline subset) | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam, без инструментов | 45,9% | 10,2% | нет данных | 56,9% |
| Humanity's Last Exam, с инструментами | 57,4% | 18,7% | нет данных | 64,5% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 (Main) | 46,4% | нет данных | 42,4% | 52,1% (xhigh) |
| Chartography, без инструментов | 46,4% | 6,4% | 29,1% | 61,6% |
Данные Anthropic (анонс 07.10.2026). Шкала Elo в графике начинается с нуля — это визуализация, а не доля. Бенчмарки производителя независимо не воспроизводились; обзорные площадки советуют считать их заявлениями до независимой проверки.
Не универсальный флагман, а быстрая рабочая лошадка. Вот где от неё есть смысл ждать больше всего.
Длинные документы, тредов, звонки: сжать до пунктов и вернуть суть.
Когда сессия агента разрослась, Haiku 5.5 ужимает историю, а старшая модель не тратит окно.
Быстро превратить вопрос в запрос, фильтр или выгрузку — тысячи раз в день.
Разложить обращения, письма и тикеты по категориям, достать поля, отправить дальше.
Ответ клиенту, пока он ещё в чате: задержка важнее глубины рассуждений.
Клики, формы, поиск по страницам: браузерные сценарии, где важна скорость хода.
Старшая модель планирует и пишет сложное, Haiku 5.5 берёт на себя быстрые, массовые подзадачи рядом: поиск, разбор, проверки.
Впервые в линейке Haiku можно выбирать, сколько модель размышляет. Подвигайте ползунок: мы показываем только то, что опубликовано.
Haiku 5.5 — первая модель Haiku с этим параметром: он управляет тем, сколько модель «думает».
Уровень по умолчанию в API. Баланс скорости и качества для большинства задач.
Для этого уровня у нас нет опубликованных цифр. Отключение мышления снижает CursorBench до 22,1–26,2% (данные Cursor).
Названия уровней — по графикам Anthropic (Low, Med, High, Xhigh, Max); по умолчанию в API — medium. Пустые полосы означают, что у нас нет опубликованных цифр, а не нулевой результат.
Пять компаний тестировали модель до релиза и привели свои цифры Anthropic.
Задержка выполнения задачи ниже более чем на 30%, вывод за ход агента — до 2,5× быстрее.
На наборе CRM-тестов, среднее по трём прогонам. Лучший результат компании на этом наборе.
Точность ответов по документам на 400 вопросах против 0,76 у Haiku 4.5. Прирост статистически значим.
Пунктов выше, чем у Haiku 4.5, при примерно вдвое меньшей задержке.
FrontierCode у Devin Fusion, где Haiku 5.5 — помощник при старшей модели.
Результаты ранних партнёров приведены Anthropic из тестирования до релиза и независимо не проверялись. У разных компаний — разные задачи и метрики, сравнивать цифры между собой нельзя.
Haiku, Sonnet, Opus или Fable: выберите задачу — получите модель, альтернативу и оговорку. Это ориентир, а не приговор.
Именно под такие массовые, быстрые задачи Anthropic её и делала: конспекты, разметка обращений, извлечение полей, запросы к базе.
Когда важна задержка: партнёр Asana сообщает о снижении более чем на 30% и до 2,5× более быстром выводе за ход агента.
OSWorld 2.1 (offline subset): 72,4% против 15,7% у Haiku 4.5 и 48,9% у GPT-6 Luna — данные Anthropic.
Для чётко очерченных кодовых задач Anthropic ставит Sonnet 5.5; Haiku 5.5 удобно подключать рядом как быстрого помощника.
Многочасовые агентные сессии и открытые задачи Anthropic относит к Opus 5.5. Haiku 5.5 пригодится как субагент.
Для самых больших, неделимых задач в семействе есть Fable 5.1 — самая тяжёлая из этих моделей. Haiku 5.5 здесь не основная.
Сравнительная задержка и параметры — по таблице документации Anthropic на 07.10.2026.
| Модель | Контекст | Ответ | Задержка | Мышление | Усилие по умолчанию | Знания до |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1 млн | 128 тыс. | Медленнее | Адаптивное, всегда включено | high | июнь 2026 |
| Claude Opus 5.5 | 1 млн | 128 тыс. | Умеренная | Адаптивное, всегда включено | medium | июнь 2026 |
| Claude Sonnet 5.5 | 1 млн | 128 тыс. | Быстрая | Адаптивное | high | июнь 2026 |
| Claude Haiku 5.5 | 1 млн | 128 тыс. | Самая быстрая | Адаптивное | medium | июнь 2026 |
Скорость лучше проверить самому: возьмите одни и те же запросы и сравните две модели.
Зайдите в app.strelka.ai: без VPN и без зарубежной карты, оплата — российской картой.
Выберите модель в каталоге приложения и сравните с Sonnet 5.5 на одном и том же запросе. Состав каталога смотрите в приложении.
Скопируйте промпты ниже, засеките время и сравните качество. Удачные формулировки сохраните.
Сожми этот текст до пяти пунктов и одной итоговой фразы: [вставьте текст]
Разложи обращения по категориям (оплата, доставка, возврат, другое) и верни JSON со списком: [вставьте 10 обращений]
Напиши SQL-запрос: заказы за последние 30 дней, сгруппированные по городу, с суммой и количеством. Таблица orders(id, city, amount, created_at).
Хорошая новость выглядит убедительнее, когда рядом написаны границы.
Бенчмарки, таблицы и результаты партнёров взяты из анонса Anthropic. Редакторы обзоров прямо советуют считать их заявлениями, пока независимые лаборатории не воспроизвели. На 09.10.2026 независимых замеров у нас нет.
Anthropic сама пишет, что для сложного агентного кодинга лучше Sonnet 5.5 и Opus 5.5: на Terminal-Bench 4.0 у Haiku 5.5 — 39,2%, у Sonnet 5.5 — 70,6%.
Среднее снижение расходов к Haiku 4.5 — около 75%: до 100 000 токенов на запрос примерно на 90% ниже, выше порога — на 50%. Но новый токенизатор даёт на ≈30% больше токенов на тот же текст, и запросы возле порога могут перейти на старший тариф.
Если вы подключаетесь к API напрямую: thinking с budget_tokens нужно заменить на adaptive и effort; temperature, top_p и top_k ограничены; prefill последнего сообщения даёт ошибку 400; старая версия инструмента computer use не принимается; блоки размышлений привязаны к аккаунту.
Киберзащита блокирует тестирование на проникновение, а запрос может завершиться отказом (stop_reason: refusal) без автоматического запасного ответа. Вход — текст и изображения, выход — только текст.
Проверьте Haiku 5.5 на своих задачах рядом с другими топовыми моделями. Без VPN и без зарубежной карты.